伤病预测模型操作细节,数据清洗与特征选择最关键
在现代职业足球的高强度赛程里,伤病预测模型正在训练场和医疗室之间承担越来越具体的日常判断,操作细节却远比算法名更决定成败。数据清洗与特征选择最关键,因为一次误判可能让球员带伤进入欧冠或英超关键战,代价直接落在俱乐部赛季目标、教练席位和球员长期健康上。
曼城医疗组每天接收来自可穿戴设备、全球定位系统、心率、睡眠和训练负荷的记录,瓜迪奥拉团队再把这些数据与哈兰德的既往肌肉伤史对齐。伤病预测模型的第一步不是训练算法,而是全部原始记录清洗成同一条可追溯、可比较的时间轴,并把迟到和重复条目逐项标记清楚。
莱比锡红牛与拜仁慕尼黑一线队都曾面对同一难题,训练设备口径不同,英超、德甲和西甲的数据字段也不一致。清洗时如果简单地把缺失的疲劳评分全部填成均值,伤病预测模型会把真正的高风险窗口抹平,特征选择随后就会偏离真实负壹号娱乐官网荷,最终教练组看到的报告也会显得过于平滑。
多特蒙德在长途客场旅行后常出现肌酸激酶异常升高,勒沃库森则要区分维尔茨的连续赛后疲劳与真实损伤信号。清洗异常值不能简单地见高就删,而要结合航班、睡眠、比赛分钟数和对抗强度判断,否则伤病预测模型会把正常恢复误读成真正潜在危险,让教练组的轮换计划失去弹性。
原始变量堆得越多,伤病预测模型越容易学到赛程噪声与训练偶然波动。特征选择要围绕负荷变化、既往伤史、年龄、位置和恢复指标做减法,德甲与英超球队常把连续三十天负荷斜率保留下来,把无意义的装备编号剔除,再让医疗组复核每个变量的临床意义。选错特征,清洗得再干净也难补。
皇家马德里与巴塞罗那医疗组在欧冠密集赛程里更看重特征筛选的稳定性,训练集和验证集必须按时间切分。用随机切分会把贝林厄姆未来的比赛信息泄漏给伤病预测模型,特征重要性被高估,清洗阶段补入的伤病记录也会让评估严重失真,最终排出的风险名单很难经得起赛前复核。
阿森纳在阿尔特塔治下把萨卡的冲刺次数、对抗次数和恢复心率做成滑动窗口特征,七天与二十八天负荷比远比单场跑动更有解释力。伤病预测模型需要这种时间结构,清洗后的连续序列才能让特征选择识别累积风险,而不是只盯一次训练异常,也能让体能教练每日提前安排具体减量。
曼联与切尔西过去几年都出现过医疗、体能和教练组的训练比赛数据分散在不同表格里的情况,伤病预测模型的输入版本互相打架。清洗规则不统一时,特征选择会把重复的伤病编码当成强信号,结果要么频繁误报,要么漏掉真正需要轮休的核心球员,重要赛前决策因此反复摇摆,长期难以稳定。
利物浦在斯洛特体系里高度依赖萨拉赫的连续输出,巴黎圣日耳曼的恩里克也要判断登贝莱能否连场首发。伤病预测模型给出的风险分层会直接影响轮换、阵型和欧冠报名,数据清洗与特征选择做得粗糙,教练组就只能凭经验覆盖模型结论,赛前训练计划也会随之明显频繁改动。
拜仁慕尼黑为凯恩和穆西亚拉设置不同预警阈值,凯恩的长期恢复曲线偏慢但稳定,穆西亚拉的训练冲刺负荷波动更大。伤病预测模型若用全队统一阈值,数据清洗后的个体差异会被压平,特征选择也容易把位置特点和年龄效应混在一起,最终让高风险球员被简单平均化处理。
国际米兰对劳塔罗的每次使用会参考模型输出,AC米兰则把预警分成观察、减量和停训三档。伤病预测模型不替代队医诊断,它把清洗后的负荷和病史特征转成可操作的提醒,特征选择决定提醒是否足够具体,也决定教练组愿不愿意采纳,医疗组与教练组的日常沟通效率同样受影响。
尤文图斯与那不勒斯开始给数据清洗环节设定责任人和版本记录,谁改了伤病日期、谁补了训练和比赛负荷都要能追溯。伤病预测模型的可解释性依赖这些底层记录,特征选择若无法说明为什么保留某个变量,医疗组很难在赛前会议上说服教练,审计时也找不到清楚完整的依据,长期信任难以建立。
欧冠扩军与国家队赛事挤压让赛程更密,俱乐部开始讨论跨联赛的数据标准,莱比锡红牛、阿贾克斯和本菲卡都在尝试统一字段口径。伤病预测模型未来会更多采用联邦学习,在不共享球员原始病历的前提下完成数据清洗规则与特征选择的协同,减少各队长期重复试错和日常沟通成本。
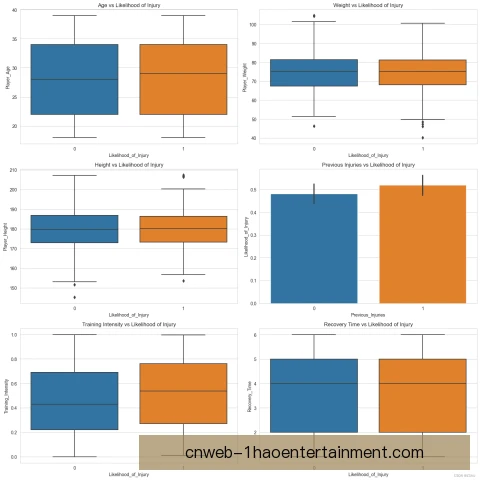
当数据清洗被写进每日训练流程,特征选择被医疗组和教练组共同复盘,伤病预测模型才真正从展示工具变成决策基础设施。它的价值不在预测某一次拉伤,而在让哈兰德、萨卡、劳塔罗这类核心球员的负荷长期可见,减少欧冠与联赛关键战的意外缺阵,也让俱乐部引援和续约更有依据。